

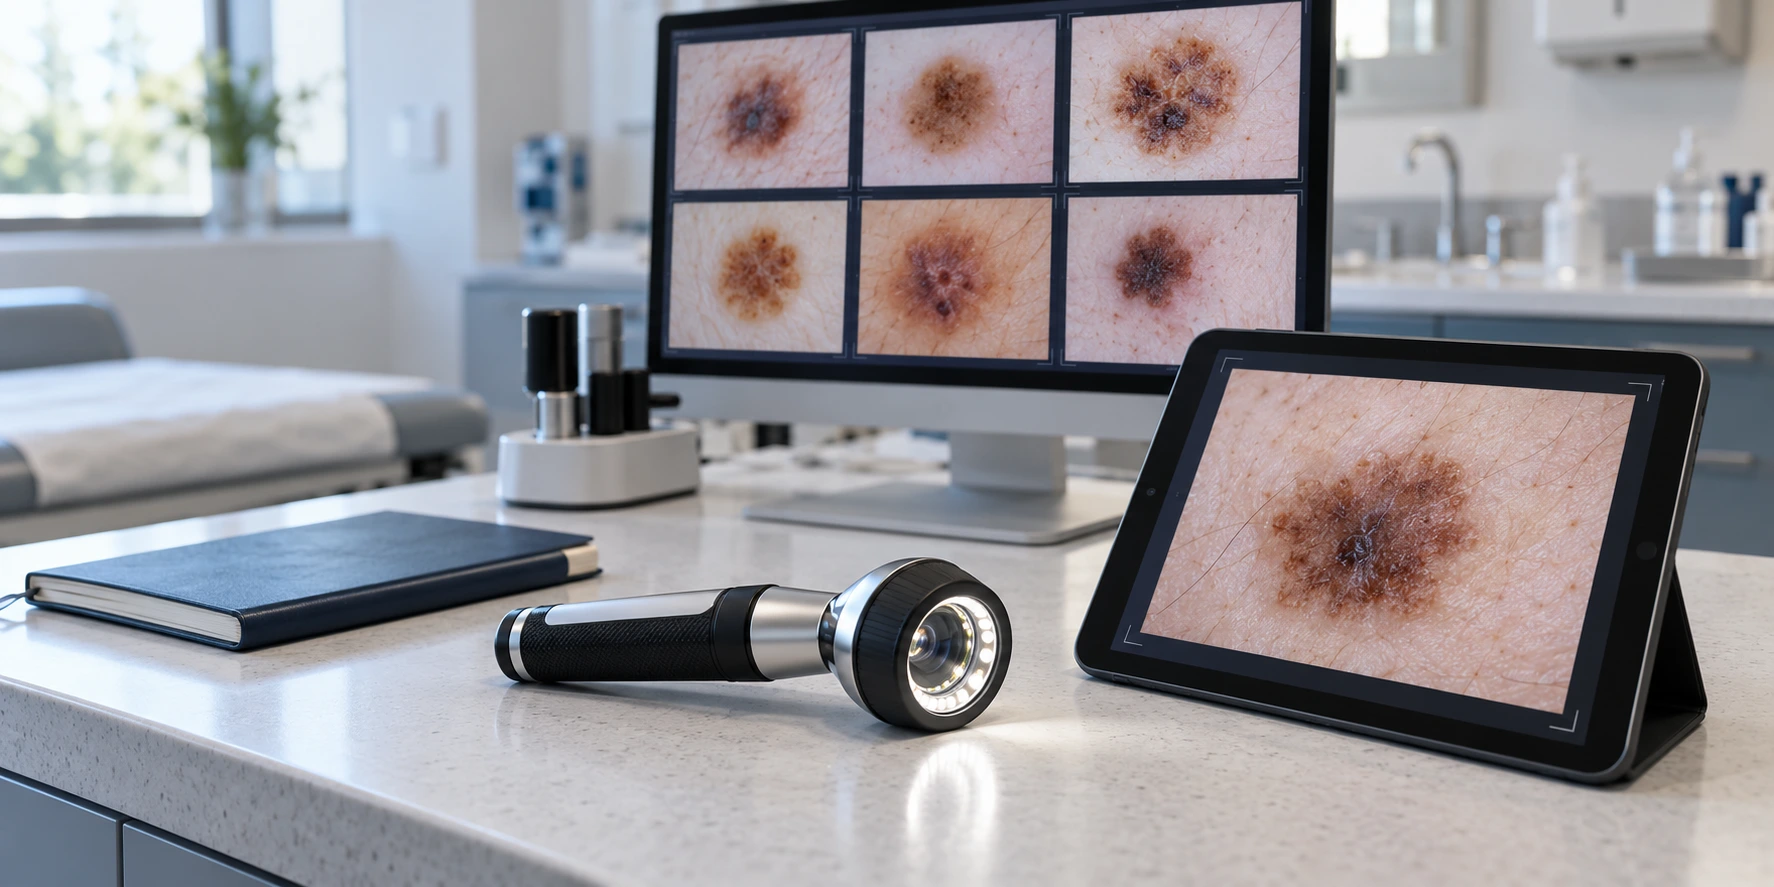
Ein Vergleich von KI zur Hautkrebserkennung ergab, dass ein älteres Bilderkennungsmodell bei der Klassifizierung von Hautläsionen besser abschnitt als zwei fortschrittliche Chatbots. Im berichteten Test wählten GPT-6 Astra und Claude Fable 5.1 jeweils in etwa 42 Prozent der Fälle die richtige Diagnose.
Im Vergleich dazu klassifizierte eine spezialisierte Version von Googles Inception v3 insgesamt 125 von 200 Hautläsionen korrekt, was 62,5 Prozent entspricht. Die Ergebnisse verdeutlichen die Unterschiede zwischen allgemeinen KI-Fähigkeiten und der Leistung bei einer spezifischen medizinischen Bildanalyseaufgabe.
Dermatologe testet drei Modelle anhand bestätigter Hautläsionen
Dr. Magnus Lynch, beratender Dermatologe und Mohs-Chirurg am Guy’s Hospital, führte den Vergleich durch. Außerdem hat er eine akademische Position als Honorary Reader am King’s College London inne.
Für den Test verwendete Lynch 200 durch Biopsien bestätigte Hautläsionen aus dem öffentlich zugänglichen Datensatz MILK10k. Die Hälfte war gutartig, während die andere Hälfte aus Krebserkrankungen oder Krebsvorstufen bestand.
Die Systeme mussten zwischen sechs Diagnosen wählen. Dazu gehörten Melanom, Basalzellkarzinom, Plattenepithelkarzinom, aktinische Keratose, gutartige Muttermale und seborrhoische Keratosen.
Wichtig ist, dass die berichtete Genauigkeit misst, ob jedes Modell die richtige spezifische Diagnose als erste Wahl auswählte. Sie misst nicht direkt, wie zuverlässig ein System sämtliche Krebsläsionen von harmlosen Hautveränderungen unterscheidet.
Älteres Modell führt den Vergleich zur KI-Hautkrebserkennung an
Lynch nahm ein Fine-Tuning von Inception v3 mit 68.000 Hautbildern und einer einzigen H100-GPU vor. Seinem Bericht zufolge dauerte das Training etwa 20 Minuten.
Die Architektur ist ungefähr zehn Jahre alt und klein genug, um auf einem Smartphone ausgeführt zu werden. Dennoch lieferte das spezialisierte Modell deutlich mehr richtige Antworten als die beiden Chatbots.
Bei den 200 Testbildern ergaben sich folgende Ergebnisse:
- Inception v3: 125 richtige Diagnosen, entsprechend 62,5 Prozent.
- Claude Fable 5.1: 85 richtige Diagnosen, entsprechend 42,5 Prozent.
- GPT-6 Astra: 84 richtige Diagnosen, entsprechend 42 Prozent.
Die Testbilder waren nicht Teil der Trainingsdaten des CNN-Modells. Der vorliegende Bericht belegt jedoch nicht, ob einer der beiden Chatbots zuvor mit Material aus dem öffentlichen Datensatz in Kontakt gekommen war.
Gutartige Hautläsionen zeigen große Leistungsunterschiede
Die größten Unterschiede zeigten sich, als die Modelle harmlose Muttermale und seborrhoische Keratosen bewerteten.
Inception v3 identifizierte 63 der 100 gutartigen Hautläsionen korrekt. Claude Fable 5.1 erkannte dagegen 39 richtig, während GPT-6 Astra 29 korrekt identifizierte.
Die Modelle zeigten außerdem eine Tendenz, bestimmte Antworten zu bevorzugen. Beispielsweise klassifizierte GPT-6 Astra 75 Bilder als Basalzellkarzinom, obwohl nur 25 Hautläsionen zu dieser Kategorie gehörten.
Ähnlich wählte Claude Fable 5.1 bei 53 Bildern die Diagnose aktinische Keratose, obwohl der Test nur 20 entsprechende Fälle enthielt.
Laut Lynch hatten alle drei Systeme Schwierigkeiten, ein Melanom als ihre erste Diagnose zu identifizieren. Das insgesamt bessere Ergebnis des älteren Modells belegt daher keine zuverlässige Melanomerkennung.
Chatbots empfahlen häufig eine ärztliche Untersuchung
Lynch untersuchte außerdem, wie die Chatbots reagierten, wenn sie gefragt wurden, ob ein Nutzer einen Arzt aufsuchen sollte.
Sie empfahlen in nahezu jedem Fall eine ärztliche Untersuchung, auch bei gutartigen Hautläsionen. Dies deutet darauf hin, dass ihre Empfehlungen zur ärztlichen Abklärung in diesem Test kaum zwischen harmlosen und besorgniserregenderen Befunden unterschieden.
Das Empfehlungsverhalten und die diagnostische Genauigkeit messen jedoch unterschiedliche Dinge. Jemandem zu einer ärztlichen Untersuchung zu raten, bedeutet nicht, dass der Chatbot die Hautläsion korrekt identifiziert hat.
Kleiner Test verdeutlicht Grenzen allgemeiner KI
Lynch räumte ein, dass 200 Hautläsionen nicht ausreichen, um Modelle mit ähnlich guten Ergebnissen zuverlässig zu bewerten. Dennoch argumentierte er, dass die Stichprobe aussagekräftige Muster in ihren Antworten offenlegte.
Der Vergleich zur KI-Hautkrebserkennung umfasste außerdem ein einfaches spezialisiertes Modell und nicht die leistungsfähigsten verfügbaren Systeme zur medizinischen Bildanalyse.
Laut Lynch kombinieren fortschrittlichere Ansätze Bildtransformatoren mit größeren Trainingsdatensätzen. Er erklärte, dass regulierte Produkte auf Basis dieser Methoden deutlich bessere Ergebnisse erzielen als sein Inception-v3-Basismodell.
Obwohl er den experimentellen Klassifikator öffentlich zugänglich machte, belegen die Ergebnisse nicht, dass er für den klinischen Einsatz bereit ist. Die Erkenntnisse beziehen sich auf einen definierten Bildklassifikationstest und nicht auf eine vollständige medizinische Untersuchung.
0 Kommentare zu „KI-Hautkrebstest: Älteres Modell schneidet besser ab als Chatbots“