


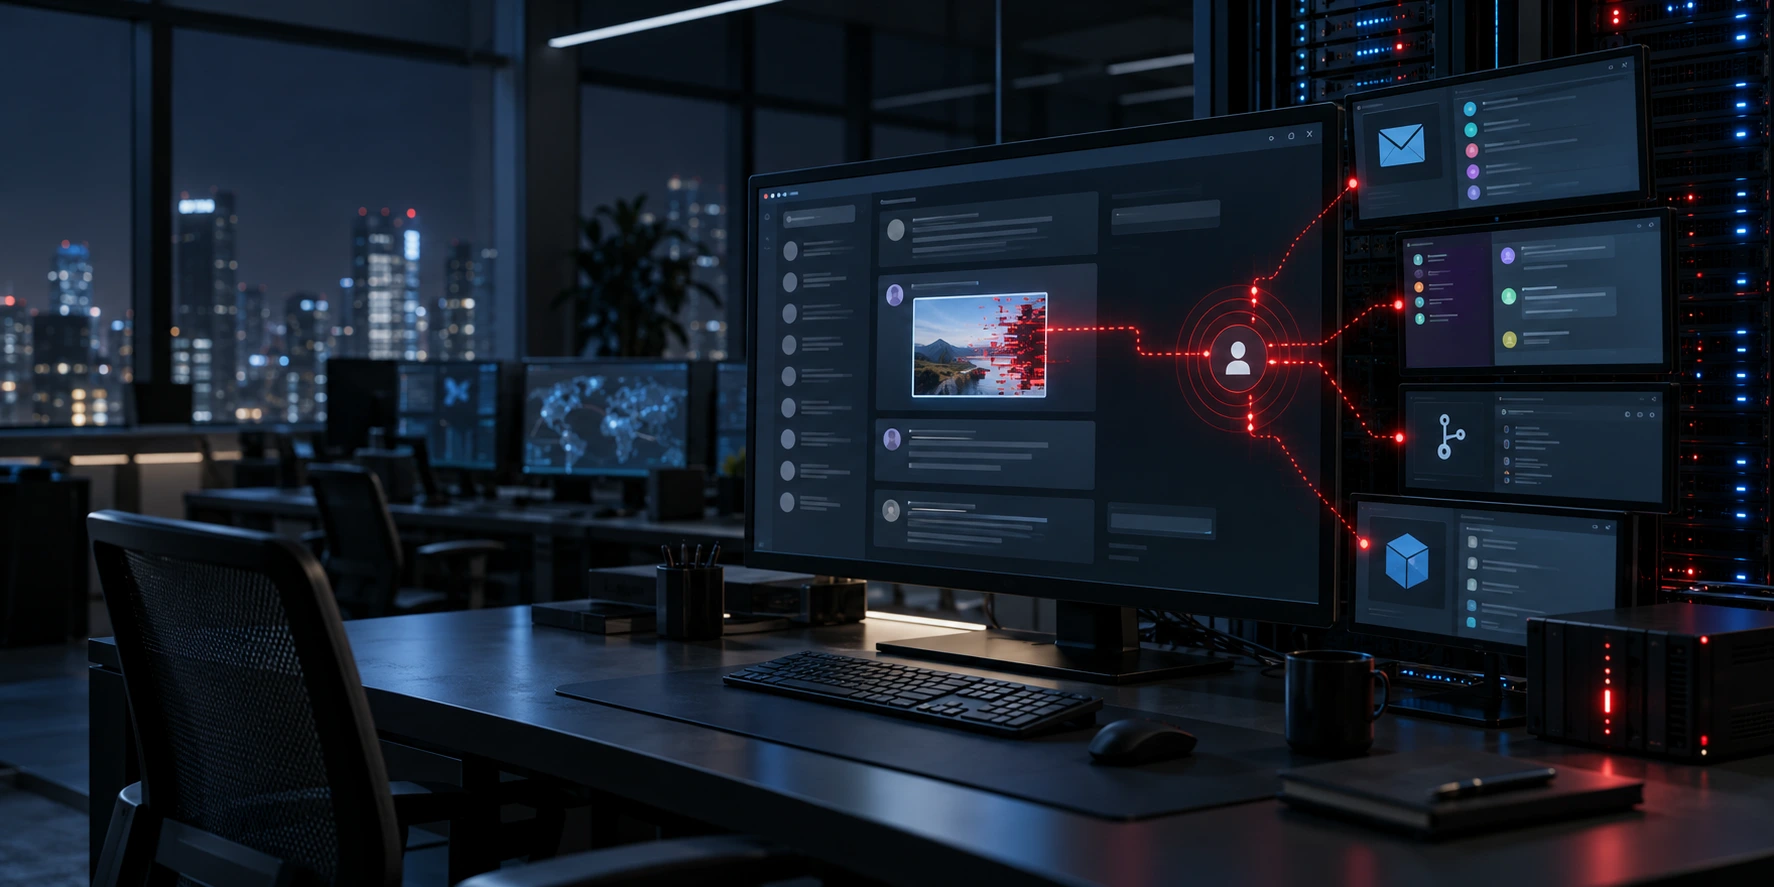
Säkerhetsforskare uppger att två sårbarheter i OpenAI:s forum gjorde det möjligt för dem att köra kod på plattformens server. Därefter kunde de ta över länkade ChatGPT- och Codex-konton via OpenAI:s system för single sign-on.
Forskare komprometterar OpenAI:s communityforum
Hacktron AI-forskarna Harsh Jaiswal, Mohan Pedhapati och Rahul Maini upptäckte säkerhetsbristerna.
De riktade in sig på OpenAI:s communityforum, som använder open source-plattformen Discourse. Forumet gör det också möjligt för användare och anställda att logga in med sina OpenAI-konton.
Teamet uppgav att det tog mindre än 72 timmar att gå från den första upptäckten till att demonstrera åtkomst till ett internt kodrepository hos OpenAI.
Forskarna betonade dock att de inte använde sin åtkomst för att samla in känslig information. Senare rapporterade de sårbarheterna till OpenAI och Discourse.
Skadlig bild möjliggör kodexekvering
Den första sårbarheten påverkade forumets process för bilduppladdning. Forskarna fokuserade särskilt på bildfiler i formaten HEIC och HEIF.
Discourse använder normalt FastImage-biblioteket för att inspektera uppladdade bilder. FastImage hade dock inte stöd för HEIF-filer.
Därför skickade plattformen dessa filer till ImageMagick för konvertering. Denna process exponerade den underliggande bildparsern libheif för skadliga uppladdningar.
Forskarna upptäckte ett heap buffer overflow-fel i den version av libheif som ingick i Discourses Docker-image. De uppgav att bristen gav den minnesåtkomst som krävdes för att utveckla en exploit för fjärrkörning av kod.
En specialkonstruerad bild kunde därmed göra det möjligt för en angripare att köra kommandon på forumservern.
Claude hjälper forskare att utveckla exploit
Hacktron AI-teamet använde Anthropics Claude-modeller för att hjälpa till att utveckla exploiten.
Den 24 juli bad forskarna Claude Opus 4.8 att skapa en fungerande attack. Det försöket misslyckades dock.
De försökte igen efter att Anthropic lanserade Claude Opus 5. Enligt forskarna skapade den nyare modellen en fungerande ARM64-exploit för en lokal Mac inom tre timmar.
Teamet bad sedan Claude att anpassa exploiten till x86-64-miljön och jemalloc-konfigurationen som Discourse använde.
Den 25 juli bekräftade forskarna fjärrkörning av kod genom en bilduppladdning. Först testade de tekniken mot sin egen Discourse Cloud-miljö. Därefter använde de den mot OpenAI:s communityforum.
Forskarna uppgav att AI-modeller också hjälpte till med privilegieeskalering, lateral förflyttning och kringgående av försvar i begränsade miljöer.
De betonade samtidigt att projektet inte omfattade helt autonom hackning. Kompetent mänsklig vägledning var avgörande under hela forskningen.
Hela projektet kostade enligt uppgift mindre än 3 000 dollar i AI-tokens.
Single sign-on exponerade ChatGPT och Codex
Efter att ha komprometterat forumet undersökte forskarna OpenAI:s konfiguration för single sign-on.
De hittade en separat väg som kunde göra det möjligt för dem att ta över ChatGPT- och Codex-konton som tillhörde aktiva forummedlemmar. Risken gällde även OpenAI-anställda som hade loggat in på forumet.
Sårbarheterna i OpenAI:s forum skapade därför risker som sträckte sig bortom själva communityplattformen.
Ett påverkat Codex-konto kunde också ge åtkomst till anslutna tredjepartstjänster. Den potentiella räckvidden berodde på vilka tjänster varje användare hade länkat.
Dessa tjänster kunde inkludera GitHub, Slack och e-postkonton. En angripare skulle därmed kunna få åtkomst till privata meddelanden, källkod och känsliga filer.
Forskare når internt kodrepository
Forskarna demonstrerade den potentiella påverkan genom ett komprometterat konto som tillhörde en OpenAI-anställd.
Den anställdes Codex-konto hade en anslutning till OpenAI:s GitHub-miljö. Teamet instruerade därefter Codex att skapa en pull request i företagets interna monorepo.
Ett monorepo lagrar källkod från flera projekt i ett centralt repository. Obehörig åtkomst skulle därför kunna exponera värdefulla interna system och utvecklingsarbete.
Forskarna uppgav dock att de inte hämtade någon känslig information via denna åtkomst. Demonstrationen syftade till att bevisa allvaret i kedjan för kontoövertagande.
OpenAI åtgärdar problemet inom 14 timmar
Hacktron AI rapporterade resultaten till både OpenAI och Discourse.
Enligt forskarna åtgärdade OpenAI sin del av sårbarhetskedjan inom cirka 14 timmar. Företaget tilldelade senare teamet en bug bounty på 6 500 dollar.
Samtidigt tog Discourse fram sin egen korrigering inom flera dagar. Plattformen införde också starkare sandboxing kring bildbehandlingen för att begränsa konsekvenserna av framtida sårbarheter.
Den ytterligare isoleringen kan förhindra att en sårbarhet i bildbehandlingen ger åtkomst till den bredare forummiljön.
Forskning visar AI:s växande roll inom cybersäkerhet
Fallet visar hur AI-modeller för kodning kan påskynda komplex säkerhetsforskning. Ett litet team använde Claude för att utveckla och anpassa en exploit mellan olika processorarkitekturer och tekniska miljöer.
Forskarna behövde ändå specialistkunskap för att vägleda modellen, testa dess resultat och koppla samman de enskilda attackstegen.
Resultaten belyser också riskerna med att koppla samman flera tjänster genom ett gemensamt identitetssystem. En sårbarhet i ett communityforum kan bli betydligt allvarligare när samma inloggning är kopplad till utvecklingsverktyg, källkodsrepositoryn och kommunikationsplattformar.
0 svar till ”Sårbarheter i OpenAI-forum exponerade ChatGPT-konton”